人文情報学月報第180号
目次
- 《巻頭言》「パネルセッション:AI への過大な期待を超えて:AAS 2026における東アジア研究と AI 「Kwok-leong Tang 鄧國亮:AI の評価と東アジア研究のあいだにある隔たり」」
:ハーバード大学東アジア言語文明学部 - 《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第96回
「辞書・文法・練習・AI をつなぐコプト語デジタル基盤:Coptic Compass」
:筑波大学人文社会系 - 《連載》「英米文学と DH」第19回
「遠読」
:中央大学国際情報学部 - 人文情報学イベント関連カレンダー
- 編集後記
- 「デジタル研究基盤としての令和大蔵経の編纂―次世代人文学の研究基盤構築モデルの提示」ニューズレター第6号(本誌「特別付録」として隔月配信)
《巻頭言》「パネルセッション:AI への過大な期待を超えて:AAS 2026における東アジア研究と AI 「Kwok-leong Tang 鄧國亮:AI の評価と東アジア研究のあいだにある隔たり」」
[編集部より] 先々月号より3回は、2026年3月、バンクーバーで開催された Association for Asian Studies 年次大会のパネルセッション「Beyond Hype: Use Cases and Evaluations of Artificial Intelligence in East Asian Studies」における趣旨紹介と3つの発表を1件ずつ掲載いたします。今回はその3回目になります。
最後の発表は、ハーバード大学の Kwok-leong Tang による「Mind the Gap: AI Capabilities and East Asian Studies Research Needs」であった[1]。最初の二つの発表が、AI を実際の研究課題にどのように用いることができるかを示したのに対し、この発表は一歩引いて、AI の能力がどのように測定されているのか、そしてその測定が東アジア研究の実際の必要とどの程度対応しているのかを問い直すものであった。
発表では、三つの主要な論点が提示された。
第一に、ベンチマークの得点が高いことは、回答の信頼性が高いことを意味しない。OpenAI 自身の SimpleQA ベンチマークは、憂慮すべきハルシネーション率を示している。GPT-4.5は約37%、推論モデルo3は51%、GPT-5は47%、小型モデルのo4-mini は79%の割合で、事実に基づかない回答を生成している[2]。OpenAI の Kalai らによる2025年の論文は、その背景にある仕組みを説明している。主要なベンチマークの10分の9は、「わかりません」と答えても得点にならない二値的な採点方式を採用しているため、モデルにとっては常に推測することが最適戦略になるのである[3]。その結果、モデルは事実上、不確実性を表明しない方向に訓練されることになる。英語においてさえハルシネーション率がこれほど高いのであれば、古典中国語、前近代日本語、韓国思想史のように、学習データや評価データにおける代表性が低い領域では、その問題はいっそう深刻である可能性が高い。
第二に、広く用いられているベンチマークには、東アジアに関する知識を評価するうえで大きな盲点がある。CMMLU、C-Eval、AC-EVAL、KMMLU、JMMLU、CulturalBench、BLEnD を含む30以上の東アジア関連ベンチマークを調査すると、モデルの成績は英語の同等ベンチマークに比べて10~30%低い[4]。GPT-4は英語の MMLU で約86%を記録する一方[5]、CMMLU では71%、JMMLU では74%にとどまる。さらに、これらのベンチマークの約80%は多肢選択式であり、一つの問いに対して単一の正答があることを前提としている。しかしこれは、人文学的な探究の性質とは根本的にかみ合わない。CulturalBench では、文化的に妥当な複数の回答を認めた場合、正答率が19.8%低下することが示された[6]。JMMLU の論文は、関連するもう一つの重要な知見を示している。すなわち、日本語ではプロンプトの丁寧さがモデルの性能に測定可能な影響を及ぼし、最適な丁寧さの水準は言語によって異なるという結果である。これは、敬語研究とも直接つながる論点である[7]。
第三に、「人類にとって最も難しい問題」を扱うとされる著名なベンチマークでさえ、東アジアの知識を十分に反映していない。HLE、すなわち「最後の閉じた形式の学術ベンチマーク」と称される2500問から成るベンチマークを精査したところ、東アジアに関係する問題は約3.9%にすぎなかった。一方で、数学だけで全体の41%を占めていた。東アジアに関連するとされる項目のかなりの部分も、実際には東アジアの歴史・思想・文化に関する知識を問うものではなく、通常の数学や計算機科学の問題に東アジア風の語彙を付け加えただけの「文化的装飾」にとどまっているとされた。
たとえば、架空の「五行思想にもとづくコンピュータ・アーキテクチャ」では、陰陽や五行の語彙が数体系のように扱われているが、そこで問われているのは中国思想の理解ではない。秦の始皇帝は文章題の登場人物として使われ、老子は誤り訂正符号を書くことになっている。この点を示すために、発表では「『陰の水』を『ゼロ』に置き換えても、問題の内容は何も変わらない」と説明された。つまり、そこで用いられている東アジア思想の語彙は、問題を解くうえで不可欠な概念として機能しているのではなく、通常の数学的・計算機科学的な記号を言い換えるための表面的なラベルにとどまっているのである。品質にも問題がある。2025年の FutureHouse による監査では、HLE の化学・生物学分野の回答の約29%が査読済み文献と矛盾していることが示された[8]。専門家の関与なしに設問が作成されることも多い人文学分野において、誤りの割合がそれより低いと考える理由は乏しい。
発表の最後では、よりよい評価のあり方が五つの層として示された。難易度の低いものから順に、第一は知識である。これは事実の想起を測るものであり、現在の多肢選択式ベンチマークが主に測定しているものである。第二は推論であり、説明し、関連づけ、応用する能力を指す。第三は文化的真正性であり、出力が単に語彙的に正しいだけでなく、文化的にも適切であるかどうかを問う。第四は認識論的謙虚さである。これは、モデルが自らの不確実性を正確に表明できるかどうかを意味する。最も重要でありながら、現在ほとんど測定されていない層である。この点は、『論語』「為政」の「知之為知之、不知為不知、是知也」――「知っていることを知っているとし、知らないことを知らないとする。それが知るということである」――という言葉によってよく表されている[9]。第五は視点の透明性であり、モデルが暗黙のうちにどの文化的枠組みから語っているのかを明らかにすることである。
このようなベンチマークを構築するには、東アジア研究の側には存在し、AI 産業の側には必ずしも十分には存在しない専門知が必要である。発表は、結論というよりも、東アジア研究の側から AI 評価に積極的に関与すべきだという呼びかけで締めくくられた。
「私たちが関与しなければ、私たちの知は誰か別の人によって代弁されることになる。」
(訳:永崎研宣)
執筆者プロフィール
《連載》「欧州・中東デジタル・ヒューマニティーズ動向」第96回
「辞書・文法・練習・AI をつなぐコプト語デジタル基盤:Coptic Compass」
はじめに
コプト語は、古代エジプト語の最終段階であり、主としてギリシア文字に、エジプト在来の文字(デモティック)に由来する数文字を加えたコプト文字で書かれる。古代末期から中世エジプトのキリスト教、社会、文学、言語を研究するための重要な言語である一方、初学者がオンラインで学ぼうとすると、辞書、文法書、練習問題、コーパス、翻訳支援が別々の場所に分散していることが多い(本連載でも、第76回で紹介したコプト語魔術文献データベース Kyprianos をはじめ、個別の資源を扱ってきた)。2026年現在公開されている Coptic Compass は、この分断を解消し、語を調べることから文法を理解し、反復練習を行い、AI に質問し、さらに構造化データを再利用するところまでを一つのウェブ環境にまとめようとするデジタル・コプト学プラットフォームである[1]。
Coptic Compass は、開発者・コプト学者 Kyrillos Wannes が創設し、独立して開発・維持している。AI エンジニアの George Joseph Basilious Tawadrous が開発協力を行い、筆者もコア・コントリビューターとして、コプト語学、計算言語学、および Shenute AI と、筆者が開発するコプト語 RAG(検索拡張生成)機械翻訳ツール THOTH AI との連携に関する助言と開発に参加している[2]。現時点ではボハイラ方言を中心とするが、単なる教会用語集ではなく、方言形、ギリシア語対応語、品詞・性などの言語学的情報を学習機能と結びつけている点に特徴がある。
辞書検索と方言情報
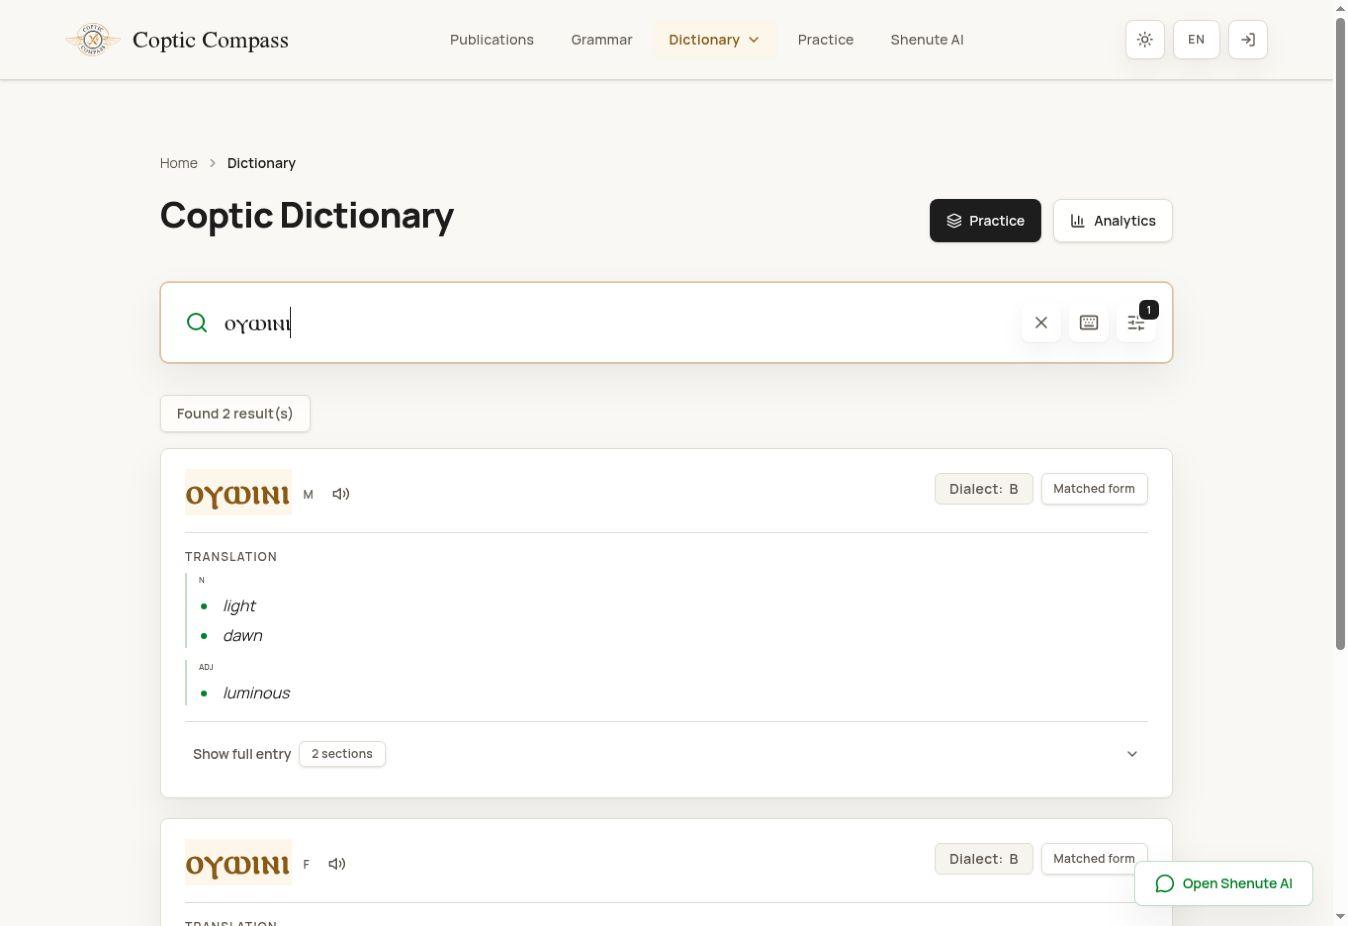
まず、上部メニューの「Dictionary」(2026年7月14日現在、6,376項目を収録)を開き、検索欄にコプト語、英語、またはギリシア語を入力する。コプト文字が手元のキーボードで入力できない場合は、検索欄右側のキーボード記号から画面上のコプト語キーボードを利用できる。例えば ⲟⲩⲱⲓⲛⲓ を検索すると、男性名詞「光、夜明け」・形容詞「明るい」と、女性名詞「竪琴」という二つの同形語が区別して表示される(図1)。見出し語カードには、方言、性、品詞、英訳、発音再生への入口がまとめられている。「Show full entry」または見出し語を開けば、ギリシア語対応語と、サイード方言、アクミーム方言、ファイユーム方言、リュコポリス方言、古コプト語などの方言形も確認できる[3]。したがって、綴りから意味を引くだけでなく、方言間比較へ進むための索引としても使える。
文法レッスン・分析・練習
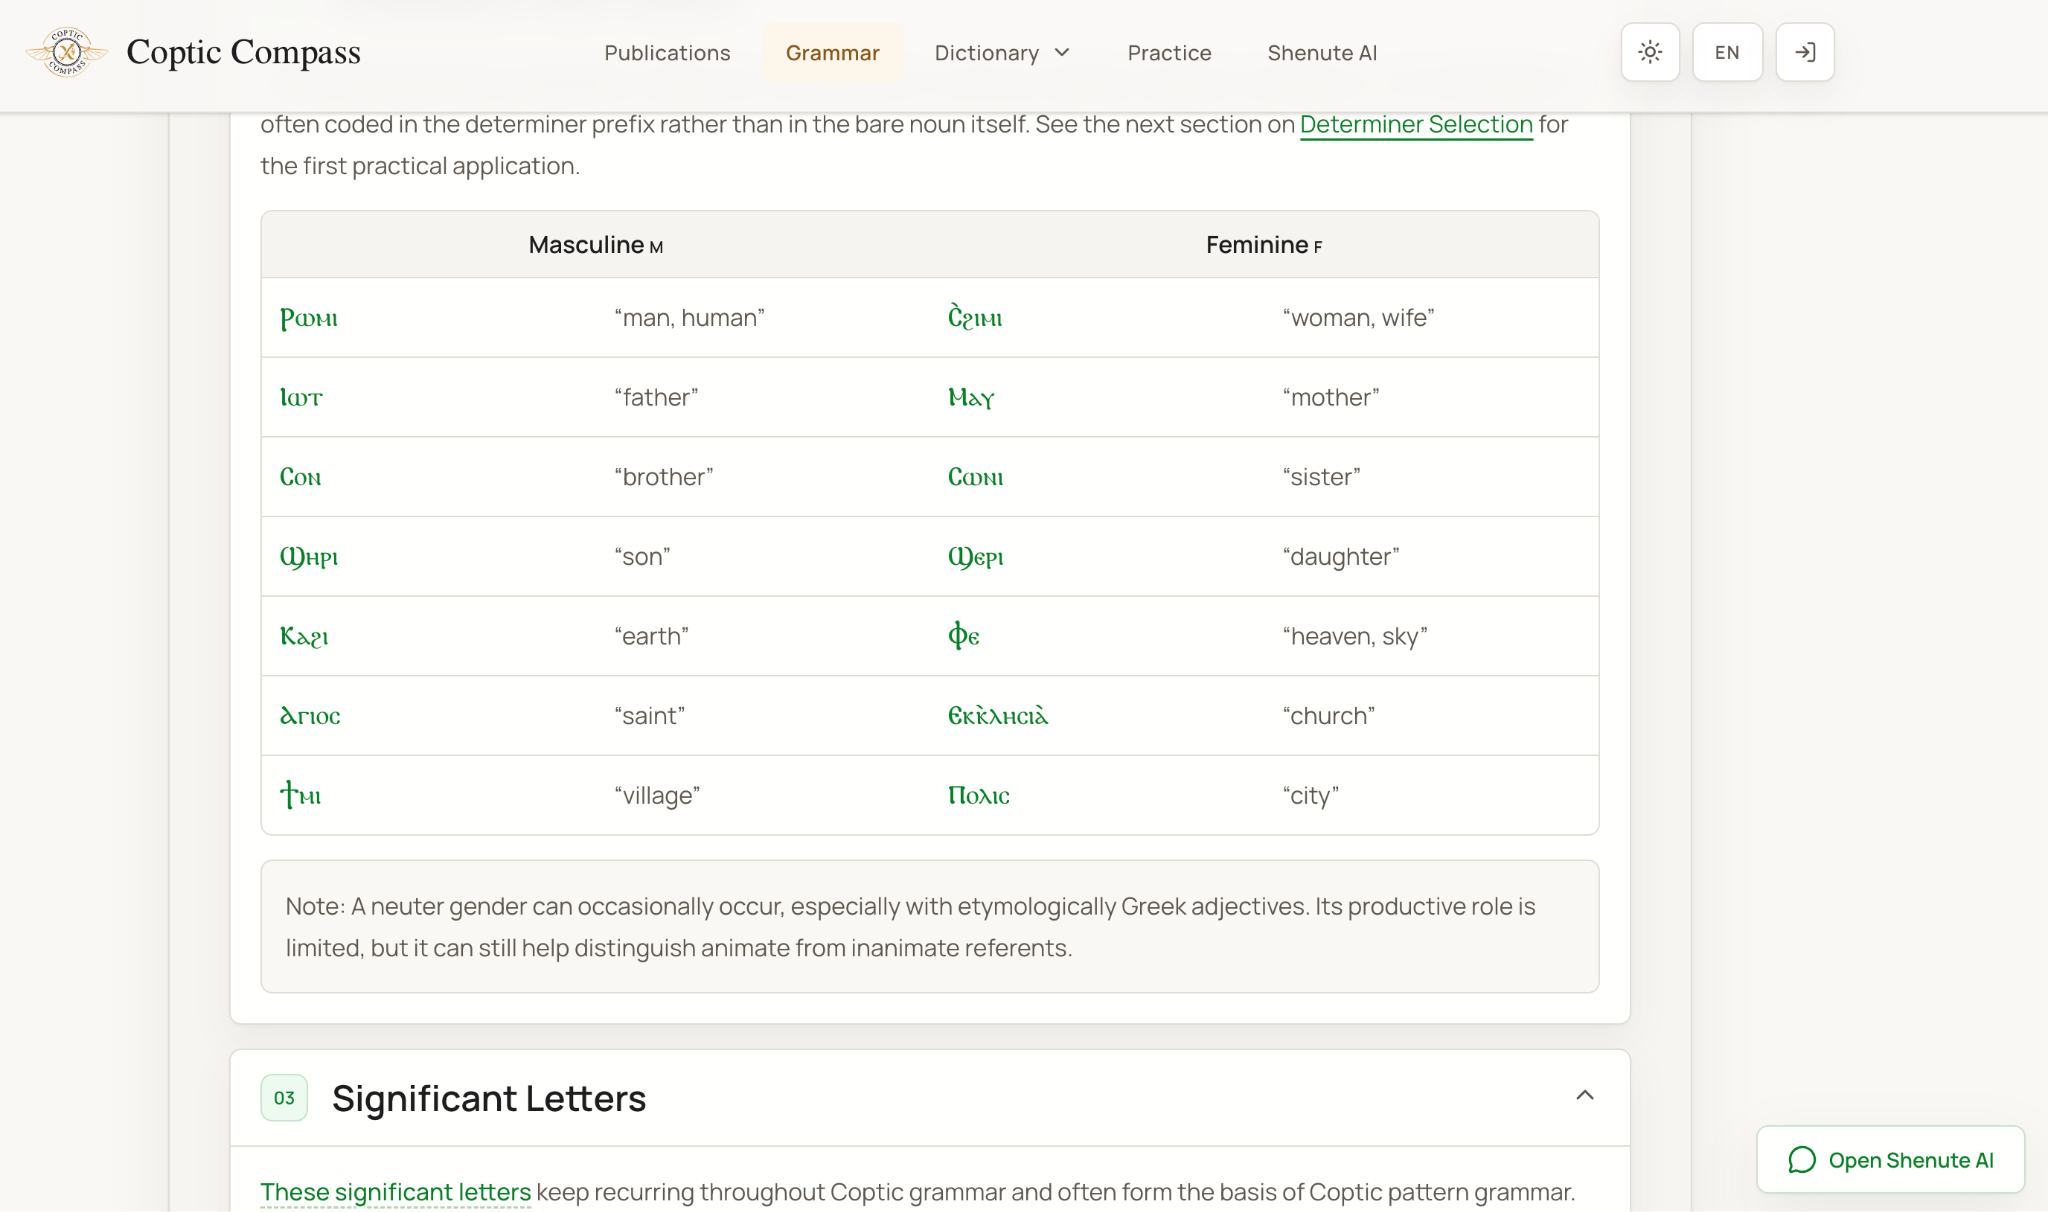
次に「Grammar」から公開済みの「Lesson 01」を開く。画面上部の lesson map には、定冠詞を伴わない名詞、限定詞、名詞文、独立人称代名詞、略記法、練習問題など十の節が並び、目的の節へ直接移動できる。各節では説明、表、例文、用語集、典拠が同じページに配置されている。とりわけ便利なのは、語彙表のコプト語が辞書項目へのリンクになっていることである(図2)。例えば ⲣⲱⲙⲓ「人」や ⲥ̀ϩⲓⲙⲓ「女性」をクリックすれば、学習中の文脈を保ったまま詳細な辞書情報へ移れる。レッスンは PDF として保存でき、「Practice this lesson」から該当範囲の練習にも進める[4]。説明・語彙・辞書・練習を相互参照可能にした設計は、紙の教材では実現しにくい利点である。
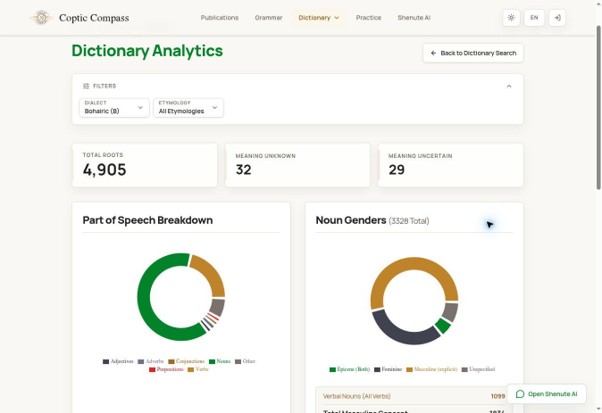
辞書画面の「Analytics」を選ぶと、個別の語を調べるミクロな閲覧から、辞書全体を眺めるマクロな分析へ切り替わる。方言と語源で絞り込み、語根総数、意味が不明・不確実な項目数、品詞構成、名詞の性、語源、派生形態論、動詞の状態形の記載状況などを可視化できる[5]。2026年7月14日現在、ボハイラ方言では4,905語根が表示され、意味不明32、意味不確実29と集計されている(図3)。この画面は、辞書の規模を示すだけでなく、未解決項目や記述の偏りを発見し、今後の語彙研究やデータ整備の優先順位を考える入口にもなる。数値はデータ更新に伴って変わるため、論文等で用いる場合は閲覧日とフィルタ条件を記す必要がある。
「Practice」では、辞書項目と文法教材から生成されたカードを使って反復練習ができる[6]。「Daily Mixed Practice」を選ぶと、コプト語の形を見て意味を思い出し、必要ならヒントを表示し、Space キーまたは「Reveal answer」で解答を確認する。復習期日を迎えた項目、初めて学ぶ項目、苦手な項目という学習モードが用意されている。ログインしなくても一部の練習は試せるが、進捗、ブックマーク、ノート、復習履歴を保存するにはアカウントが必要である。授業では、教師が Grammar の該当節を指定し、学生が辞書で語を確認した後に該当範囲の Practice に進む、という一続きの課題に組みやすい。
Shenute AI と公開 API
もう一つの柱が「Shenute AI」である。これはコプト語の語彙、文法、翻訳、写本文脈について質問でき、画像の追加やカメラ入力にも対応する対話型支援機能である[7]。THOTH AI の専門モードを含む RAG 型の仕組みを利用し(RAG の概要は本連載第79回で解説した)、OCR で画像から得たテキストも質問の文脈に加えられる。ただし、利用にはログインが必要であり、回答は校訂本文や辞書項目そのものではない。綴り、方言、形態素分析、出典を辞書・文法書・原資料と照合し、AI の提案を研究上の結論と混同しないことが重要である。むしろ「候補を得る→辞書項目を開く→方言形と文法を確認する」という検証の循環を作りやすい点に価値がある。
Coptic Compass は一般利用者向けの画面だけでなく、開発者向けの公開 API も提供する[8]。OpenAPI 文書から、公開済み文法レッスンの一覧、正規化された辞書検索、辞書索引、Shenute AI、OCR プロキシの仕様を確認できる。辞書 API では検索語、方言、品詞、完全一致、取得件数、開始位置を指定でき、文法データにはスキーマとデータセットの版情報が付される。これにより、研究用ノートブックから語彙を取得したり、授業用の小規模アプリを作ったりすることが可能になる。一方、公開 API は閲覧・連携のための窓口であり、データの再配布や出版利用に際しては、各ページの典拠と利用規約を確認すべきである。
おわりに
以上のように、Coptic Compass の強みは、巨大な単一コーパスを提供することよりも、辞書・文法・反復練習・AI・API を相互に接続し、学習と研究の移動距離を短くした点にある。現段階ではボハイラ方言が中心で、文法レッスンも拡充の途上にあるが、未完成部分を含めて更新可能なデジタル基盤として設計されている。初学者には「次に何をすればよいか」が見える学習経路を、研究者には個別項目から方言比較、辞書全体の分析、API 利用へ進む経路を提供する。コプト語資料を読む際、Coptic Compass を最終的な権威としてではなく、典拠へ到達し、問いを精密化し、検証を反復するための「羅針盤」として用いることが、このプラットフォームを最も有効に生かす方法であろう。
《連載》「英米文学と DH」第19回
「遠読」
前回の連載では、データの扱いが伝統的な人文学研究と統計の分野で異なること、また DH の人文学領域と統計を利用する分析で異なることを示した。伝統的な人文学研究では、特徴をよく表すと思われるテクストや要素を取り上げてその時代や作家、ジャンルの代表とみなすのに対し(例として、19世紀後半イギリスの推理小説といえばシャーロック・ホームズなど)、統計分野では母集団におけるサンプルという形でデータを代表することを示した(19世紀後半イギリスに書かれたあらゆる推理小説作品という理論上の母集団に対し、その特徴をよく表すと思われる無作為に選んだ150作品など)。また DH の人文学領域においては、データ構築とデータ分析の両段階で収集したデータに偏りがないか批判的な検討が加えられるのに対し(19世紀後半イギリスの推理小説の作品群において、ジェンダーや人種、思想的偏り、あるいは政治的時代的な出版事情によるデータの欠落がないかなど)、統計的な手法を用いる DH 研究では、集められる限りのデータを集めて使うという傾向があることを述べた。これらは学問分野ごとのデータの扱いの違いであり、優劣があるわけではないし、どれか一つに軍配をあげることもできない。統計によって示される特徴が本質を捉える場合もあれば、スピヴァクの固有性によって示されるような特徴もまた本質を示すのである。
以上のようなデータの扱いの違いと文理融合の決して容易でない道のりを踏まえた上で、今回から数回をかけて、DH の文学領域における分析型研究の要といえる遠読を扱いたい。
遠読
これまでの連載で、遠読とは、大量のテクストからパターンを見出し可視化することであると述べた。少し詳しく定義すれば、遠読とは大量の文学テクストを俯瞰しそこにあらわれる特徴的な傾向を視覚的に選び示す読みである。大量の文学テクストには、カノンと呼ばれるスタンダードとされる文学テクストの他に、カノンに含まれなかったあまたのテクスト、翻訳、研究書そしてメタデータが含まれる[1]。解釈ではなく説明に近く、テクストの変遷の大規模な、したがって射程の大きなパターンを見出す行為である[2]。
この定義は、2000年以降のフランコ・モレッティの研究[3]を念頭に置いているが、遠読にあたる文学作品を数量的に読み解く試みは、モレッティ以前の計量文献学や、コンピュータ以前の文体論研究にみられる。例えば、ジョン・F・バロウズは1987年ジェーン・オースティンの小説における語彙の頻度と登場人物の関係を平面図に示して分析した[4]。またヨーヘイ・イガラシは、20世紀初頭のルーシャス・アデルノ・シャーマンやエディス・リカートの科学的な文学研究を1950年代のスティーブン・マックスフィールド・パリッシュが再評価したことを示した[5][6][7][8]。シャーマンは、ダンテの煉獄編の一節で作者が仕掛けた詩のイメージについて、読者の心的状況を図示して解説し[9]、またリカートは、韻律を色と記号のパターンで印す手法を提案し、ロバート・フロストの「カンバの木」の韻律を図示した[10]。パターンを見出す図表に示す意味での遠読からは離れるが、シャーマンやリカートらの知見を礎として、パリッシュはマシュー・アーノルドのコンコーダンスをコンピュータで作成し、1965年に開催した文学データ処理学会でコンピュータを用いた文学研究の到来を喝采した[11]。なおその同じ学会で、ジョセフ・レイブンはミルトンとシェリーの影響をコンピュータで分析した結果を発表している[12]。日本ではホイト・ロングが量的方法による文学の読解の例としてあげるように漱石の『文学論』が有名であるが[13]、読者の専門の知見に照らして、より古い文献を遠読の例としてあげることももちろん可能だろう。
遠読は、モレッティの批評によって文学批評や文学研究者の間で知られるようになった手法であり、遠読の用語の対になる精読と同じく、研究者の間で自然発生的に出てきた用語である[14]。欧州では遠読と同じ意味を表す、しかしながらより広い研究を包摂する用語として計算文学研究が用いられる[15]。これは学会等で定められた用語であり、組織によって定められたものである以上、エコロジカルなライフサイクルとしての組織の終了や別の同種の組織の勃興によって異なる用語が使われる可能性がある。
精読
モレッティが対話的補完物として定める精読は、文学研究の代表的かつ伝統的な手法である。それはテクストを精緻に読み込むことで言葉の意味や形式、それらの複雑な統一を見出す試みである。ジョン・ギロリーによれば、精読とは身体的な技法の一つであり、ゆっくりと「ページ上の言葉に対し注意を凝らす」(p. 37)実践であり、同時に気を逸らす実践でもある最小の形式を持つ。対象に意識を集中して認知能力を働かせその後意識を逸らす精神の働きを表現している[16]。またある研究者がいうように、精読とは文学研究以外の他の領域に転用可能なものである[17]。
このような、ゆっくりと注意をもってテクストを精緻に読むという読みの技法が精読である。筆者はイギリス文学の範囲でしか知らないが、ギリシア・ローマ時代から言及があり、欧州でも読みの理論は、少なくともインターテクスチュアリティの時代には盛んに議論された。イギリス文学では、I.A.リチャーズ、F.R.リーヴィス、ウィリアム・エンプソン、T.S.エリオットといった1920年代から30年代の文芸批評でテクストの読みについて盛んに議論がなされた。その後アメリカでジョン・クロウ・ランサム、クリアンス・ブルックス、ウィリアム・ウィムザットらの批評家が出て、ニュー・クリティシズムと呼ばれた[18]。
ここでは概要にとどめるが、精読が少しのテクストのみを対象とし、ページ上の言葉に注意を払って時間をかけて精緻に読み込むテクストの内容に密接に関連したゆっくりした作業であるのに対し、遠読は大量のテクストから共通するパターンを取り出す、異なる方向性の読みであることが理解されるだろう。
以上、今回は遠読と精読の定義をみた。次回はモレッティらの実例をもとに、実際の遠読の分析をみたい。
余談であるが、この連載の初めに、ハティトラスト・リサーチセンターの各種サービスが利用できなくなるかもしれないとの懸念と、記録のためのシステムの連載を行なった。ハティトラスト・リサーチセンターは2026年9月30日をもって終了することになった(リサーチセンターはハティトラスト・デジタルライブラリーとは別組織である。ハティトラスト・デジタルライブラリーは継続する)[19]。スティーブン・ダウニー氏によれば、今後については、語彙頻度表をメタデータに埋め込んだ人文学関連のデータセットと、そのデータセットを用いて可視化ができる TORCHLITE を計画中とのことである[20]。著作権のきれた文学テクストについていえば、インターネットアーカイブ等で検索およびダウンロードすることもできるが、ハティトラスト・デジタルライブラリーのリサーチ・データセットで提供されていない電子テクストについては注意する必要があるだろう。ただし著作権については、DH の研究者が注意を向ける部分と情報法の研究者が注意を向ける部分は必ずしも重ならないため、専門家を交えた理解が不可欠である。
人文情報学イベント関連カレンダー
【2026年8月】
-
2026-8-6 (Thu), 11 (Tue), 20 (Thu), 25 (Tue)
TEI 研究会https://tei.dhii.jp/於・オンライン -
2026-8-7 (Fri)
DiHuCo ハブシンポジウム2026:Agentic DH に向けて~人文学×AI の多様化と AI 協働型研究の広がりhttps://codh.rois.ac.jp/symposium/agentic-dh-2026/於・一橋講堂およびオンライン -
2026-8-10 (Mon) ~ 2026-8-14 (Fri)
TEI 2026: Creating Connections, Unsettling Practiceshttps://tei2026.tei-c.org/於・The University of British Columbia -
2026-8-20 (Thu) ~ 2026-8-21 (Fri)
Japanese Book History and Digital Humanities Workshophttps://macmillan.yale.edu/eastasia/events/2026-08-20/japanese-book-history-and-digital-humanities-workshop於・Yale University
【2026年9月】
-
2026-9-1 (Tue) ~ 2026-9-4 (Fri)
The 36th EAJRS Conferencehttps://www.eajrs.net/於・Leiden University -
2026-9-3 (Thu), 8 (Tue), 17 (Thu), 22 (Tue)
TEI 研究会https://tei.dhii.jp/於・オンライン -
2026-9-6 (Sun) ~ 2026-9-7 (Mon)
Code4Lib JAPAN Conference 2026https://wiki.code4lib.jp/wiki/C4ljp2026於・皇學館大学 -
2026-9-9 (Wed) ~ 2026-9-11 (Fri)
PNC 2026 Annual Conference and Joint Meetingshttps://sites.google.com/view/pnc2026/about-pnc於・Dharma Drum Institute of Liberal Arts -
2026-9-11 (Fri) ~ 2026-9-13 (Sun)
JADH2026https://www.jadh2026.kyushu-u.ac.jp/home於・九州大学 -
2026-9-15 (Tue) ~ 2026-9-19 (Sat)
EADH 2026https://eadh2026.confer.uj.edu.pl/en_GB於・Jagiellonian University
【2026年10月】
-
2026-10-1 (Thu), 6 (Tue), 15 (Thu), 20 (Tue), 29 (Thu)
TEI 研究会https://tei.dhii.jp/於・オンライン
Digital Humanities Events カレンダー共同編集人
◆編集後記
本欄で先月ご紹介したDH国際シンポジウムは、生成AIと人文学の今後を見据えた活発な議論が展開され、おかげさまで盛況でした。それに加えて、今月末は韓国で、アジア初の対面での国際DH学会が開催されます。いずれも詳細はまた後ほどみなさまと共有できればと思っておりますので、引き続きよろしくお願いいたします。